ゆるいブログ

毎日おもったことや、やったことをただただ書いていくブログです

DeepInferとは何か――DeepSeekの圧倒的な推論速度を支える5つの最適化アーキテクチャ

DeepInferとは何か――DeepSeekの推論を支える最適化の全体像

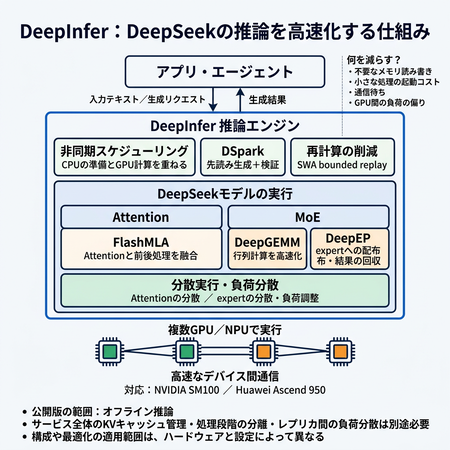
DeepSeekがオープンソースとして公開した推論フレームワーク「DeepInfer」の最大の特徴は、「モデル固有の計算処理から複数GPUによるクラスタ運用に至るまで、推論スタック全体を徹底的に最適化している」という点にあります。

本記事では、DeepInferのアーキテクチャや役割、そして推論を高速化する5つの主要な最適化技術について、構造的に整理して解説します。


推論スタックにおけるDeepInferの位置づけ

DeepInferは、DeepSeekが大規模な商用本番サービスで実際に運用している推論フレームワークです。モデルを動かす低レベルな計算処理と、ハードウェアリソースを最大限に引き出して実行する仕組みを提供します。

本フレームワークは、オープンソースのデファクトスタンダードである vLLM を主な出発点としつつ、SGLang や NVIDIAの TensorRT-LLM の設計思想からも着想を得て再構築されています。

AIシステム全体におけるDeepInferの立ち位置を整理すると、以下の関係になります。

レイヤー 役割 具体例
アプリ・エージェント 指示の送信やツール利用を通じた作業実行 OpenCode、Harness
モデル 入力から出力を算出するための構造・アーキテクチャ・重み DeepSeekモデル群
推論エンジン モデルの計算を高効率・低遅延で実行する基盤 DeepInfer
ハードウェア 物理的に並列計算を実行するアクセラレータ NVIDIA GPU、Huawei Ascend NPU

モデル構造に特化した計算処理の最適化

DeepInferは、DeepSeekが独自に開発した3つの最適化ライブラリ(FlashMLA、DeepGEMM、DeepEP)を緊密に統合しています。それぞれの役割を把握することで、どこがどのように高速化されているのかが見えてきます。

ライブラリ 主な担当領域 高速化のアプローチ
FlashMLA Attention計算 専用カーネルの実装、処理の融合(Kernel Fusion)、低精度KVキャッシュ
DeepGEMM 行列計算・MoE Tensor Coreの徹底活用、複数の行列積演算の集約
DeepEP GPU間通信(All-to-All) 担当Expertへの高効率なトークン転送と結果の集約

FlashMLAでは、位置情報を付与するRoPE(Rotary Position Embedding)、Attention計算、数値形式の変換処理を1つのカーネルに融合(Kernel Fusion)して実行します。これにより、カーネルの起動オーバーヘッドや、グローバルメモリを介した中間データの余分な読み書きを最小限に抑えています。

また、DeepGEMMにはMoE(Mixture of Experts)向けの通信、行列計算、活性化関数、結果集約を統合し、GPU間通信と計算処理をオーバーラップ(重複実行)させる「Mega MoE」構成が備わっています。単なる計算速度の向上にとどまらず、通信の待機時間そのものを隠蔽する高度な設計です。


MLAと低精度化によるメモリ使用量・転送量の削減

推論効率のボトルネックを解消する鍵となるのが、MLA(Multi-head Latent Attention)と低精度データ形式の組み合わせです。

  • MLA(モデル構造の工夫): 過去トークンのKey・Value(KV)情報を低次元の潜在ベクトルに圧縮して保持し、キャッシュ容量を大幅に削減するアーキテクチャ。
  • 低精度化(データ表現の工夫): 数値をより少ないビット幅で表現し、メモリ上に保存・転送するデータサイズそのものを削減するアプローチ。

これらは互いに補完し合う異なる技術です。FlashMLAにはFP8やFP4形式のKVキャッシュを直接処理するカーネルが組み込まれています(ハードウェアや利用シナリオに応じた制約が存在します)。

推論を高速化する上では、「KVキャッシュがGPUメモリの容量内に収まるか」だけでなく、「トークンを生成するたびにメモリバスからどれだけのデータ量をロードする必要があるか(メモリスループットの制約)」をいかに抑えるかが極めて重要です。


複数GPUを効率よく使い切るクラスタ最適化

DeepInferは、Attention層やMoE層の処理を複数のGPUに適切に分散し、特定Expertへのアクセス集中による負荷の偏りを動的に緩和します。さらに、CPU側で次のバッチ処理を組み立てるスケジューリングと、GPUによるデバイス実行を非同期かつ並行して進めます。

GPUの台数を増やしても、一部のノードに負荷が集中したり通信待ち(バリア同期)が発生したりすると、スケーラビリティは頭打ちになります。DeepInferは、クラスタ内のすべてのハードウェアが常にフル稼働できる並列化パイプラインを実現しています。


投機的デコーディングと再計算削減による生成の加速

生成速度(Latency)を向上させるアプローチとして、DeepInferは投機的デコーディング(Speculative Decoding)技術である「DSpark」を搭載しています。ドラフトモデルが先行してトークン候補を生成し、メインモデルが信頼度に基づいて並列検証を行うことで、推論ステップあたりの出力効率を大幅に引き上げます。

さらに「SWA bounded replay」機構により、特定の整合性条件を満たす末尾のコンテキスト範囲のみを再計算する仕組みを採用しています。過去の文脈を最初からすべて計算し直す無駄を省き、反復計算のコストを最小限に抑制しています。


運用の再現性と実用性を高める機能群

DeepInferは性能面だけでなく、エンタープライズや実サービスで求められる運用性にも配慮されています。

  • Batch-invariant推論: バッチサイズやリクエストの混ざり具合によって推論結果がブレるのを防止する機能。
  • 決定的サンプリング(Deterministic Sampling): パラメータやシード値を固定した場合に完全に再現可能な出力を担保する仕組み。
  • 構造化出力: JSON Schemaなどの定義に沿ったフォーマットを強制するデコード制御。

(一部の再現性担保機能は、ハードウェア依存の制約があります)


公開版の仕様と今後の活用ポイント

DeepInferのオープンソース版における対応環境とライセンスの要点は以下の通りです。

  • 対応モデル: DeepSeek-V4.1-Flash(順次拡張予定)
  • 対応ハードウェア: NVIDIA SM100世代GPU、Huawei Ascend 950 NPU
  • ライセンス: Apache License 2.0

なお、今回公開されたリポジトリは「オフライン推論」を中心とした構成です。商用のオンラインサービスとして完全運用するには、グローバルなKVキャッシュ管理、Prefill(プロンプト処理)とDecode(生成処理)の分離アーキテクチャ(Disaggregation)、レプリカ間の動的ロードバランサなどを別途組み合わせる必要があります。


まとめ

DeepSeekの圧倒的な処理速度と低コストなAPI運用を支えているのは、単一のハードウェア性能や個別の高速カーネルだけではありません。

「モデルアーキテクチャ(MLA/MoE)」「低レベル計算カーネル(FlashMLA/DeepGEMM)」「クラスタ間通信(DeepEP)」「投機的スケジューリング」が一体となったシステムレベルの包括的最適化こそが、その真価です。

LLMのサービング効率やインフラコストの削減を検討するエンジニアにとって、DeepInferの設計思想は極めて実践的な知見を提供してくれます。

DeepSeek V4.1 Flash 1017の実力を解放する:dsh-TUIとOpenRouterで組む爆速ターミナル開発環境

DeepSeek V4.1 Flash 1017の真価を引き出す:dsh-TUIとOpenRouterで構築する高速ターミナル開発環境

はじめに:DeepSeek V4.1 Flash 1017の卓越した性能とハーネスの必然性

「DeepSeek V4.1 Flash 1017」は、極めて高い推論スピードと高精度なコード生成能力、そして圧倒的なコストパフォーマンスを誇るモデルです。特に連続したツール呼び出し(Function Calling)や大規模なコンテキスト処理において、従来の軽量モデルを大きく凌駕する切れ味を発揮します。

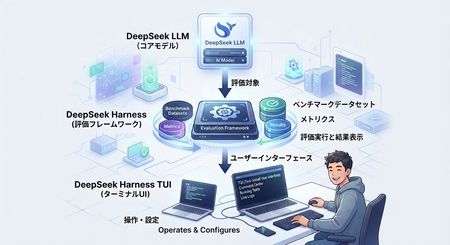
しかし、この優れた性能を単なるWebブラウザ上のチャットや受動的なGUIエディタの補完機能だけで利用していては、モデルの真価をフルに引き出せているとは言えません。DeepSeek V4.1 Flash 1017の圧倒的なレスポンス速度と自律性を活かしきるためには、モデルの出力したツール呼び出しを即座にシェルコマンドやファイル変更へ反映し、実行結果を途切れなくモデルへ返す「公式エージェント実行ハーネス(DeepSeek Harness / dsh)」との直接的な連携が不可欠です。

GUIツールとターミナル指向ツールの違い

統合開発環境(IDE)やGUIエディタ内でモデルを切り替えて利用する構成は、各種ツールが最初から統合されており手軽に使える利点があります。

一方で、軽量なターミナルインターフェースであるdsh-TUI(DeepSeek-TUI)や公式エージェント実行ハーネスを利用する構成は、エディタの画面を介さずターミナル上で直接コマンド実行やファイル操作のループを回す設計になっています。

GUIエディタでは開発環境の中にAIを呼び出す形になりますが、ターミナルベースのハーネス構成では、モデルのツール実行ループに直接接続して操作を進めます。オーバーヘッドが少なく、コマンドラインでの作業フローと親和性が高い点が特徴です。

モデル実行における「推論」と「実行環境」の分離

この構成を理解するうえで重要なのは、「推論を担うLLM」と「ファイル操作やコマンド実行を担うハーネス環境」を切り分けて考えることです。

LLM自体は入力コンテキストに基づいてテキストや関数呼び出しを出力する推論エンジンです。

それに対してハーネス側は、モデルが出力したツール呼び出しを実際のシェルコマンドやファイル変更として反映し、その実行結果を再びモデルへフィードバックする自律ループの役割を担います。開発作業を効率化する上では、モデル自体の性能だけでなく、どのような実行環境やツール呼び出しの枠組みを組み合わせるかも極めて重要になります。

dsh-TUIでカスタムプロバイダーを利用するメリット

専用のCLIやTUIを利用する際、特定プロバイダーのAPIに固定されていると思われがちですが、dsh-TUIには外部プロバイダーや互換APIを設定できる柔軟性があります。

モデル、実行フレームワーク、TUIインターフェース、推論APIプロバイダーをそれぞれ分離して管理できるため、利用目的に応じてモデルやエンドポイントを自在に切り替えられます。たとえば、高速応答やコスト効率に優れたDeepSeek V4.1 Flash 1017を組み合わせることで、ターミナル上でのコーディング支援をより軽快に動作させることが可能です。

APIアグリゲーターを活用する利点

OpenRouter などのAPIアグリゲーターを経由することで、単一プロバイダーの障害やレイテンシ変動の影響を抑えつつ、複数のモデルを用途に応じて統一的なインターフェースで利用できます。

ローカル環境のTUIと外部のルーティング基盤を組み合わせることで、手元の開発環境をシンプルに保ちながら、安定した推論リソースを確保できます。

実践:OpenRouter経由でdsh-TUIをセットアップする

ここからは、dsh-TUIのバックエンドとして OpenRouter を設定し、モデルを呼び出す具体的な手順を解説します。

構成要素

項目 担当コンポーネント 役割
推論モデル deepseek/deepseek-v4.1-flash-1017(または利用可能なDeepSeekモデル) 推論処理およびツール呼び出しの生成
実行系 DeepSeek Harness コマンド実行、ファイル編集、自律ループの処理
インターフェース dsh-TUI ターミナルでの対話表示・履歴管理
APIプロバイダー OpenRouter API モデルルーティングとAPIキー管理の集約

1. APIキーの設定

まず、ターミナル環境でOpenRouterのAPIキーを環境変数として定義します(PowerShellの場合の例)。

$env:OPENROUTER_API_KEY = "sk-or-v1-your-api-key"

2. プロファイル設定ファイルの編集

dsh-TUIの設定ファイルである cordis.patch.yml を編集し、OpenRouterをカスタムプロバイダーとして登録します。標準的な配置パスは以下の通りです。

C:\Users\<ユーザー名>\.dsh\profiles\dsh-tui\cordis.patch.yml

ファイル内に以下の設定を追加します。利用したいモデルIDを指定してください。

- id: llm-pi-ai
  config:
    providers:
      openrouter-custom:
        apiKeyEnv: OPENROUTER_API_KEY
        api: openai-completions
        baseURL: https://openrouter.ai/api/v1
        models:
          - id: deepseek/deepseek-v4.1-flash-1017

- id: dsh-tui
  config:
    provider: openrouter-custom
    model: deepseek/deepseek-v4.1-flash-1017

※既存の設定ファイル内に同じ id が定義されている場合は、既存ブロックのキー構造に合わせてマージしてください。

3. 起動とモデル切り替え

設定ファイルを保存した後、dsh-TUIを起動します。プロンプト内で /model コマンドを実行し、設定したモデルが選択可能になっていることを確認して切り替えます。

4. ツール呼び出しと実行ループの動作確認

設定完了後は、テスト用の安全な作業ディレクトリを作成し、エージェントループが正常に完走するかを検証します。

  1. ファイル走査:プロジェクト配下のファイル一覧や構成が正確に取得できるか
  2. コード生成・編集:差分修正やファイルの追記が正常に行われるか
  3. コマンド実行:テストやリンターのコマンドが問題なく呼び出されるか
  4. フィードバック反映:コマンドのエラー出力を読み取り、修正案を再提示できるか

APIアグリゲーター経由でも会話履歴とツール呼び出しのコンテキストが途切れずに継続できることを確認できれば、セットアップは完了です。

まとめ

DeepSeek V4.1 Flash 1017の驚異的なレスポンスと高いコーディング推論力は、公式ハーネスと直結したdsh-TUI環境でこそ本来のポテンシャルを解放できます。さらにOpenRouterのような柔軟なルーティング基盤を組み合わせることで、開発環境に縛られず安定した推論基盤を手に入れることが可能です。ターミナル中心の軽快で自由度の高い作業フローを求める方は、ぜひこの構成を試してみてください。

月額3,000円のGrok Botが想像以上に優秀だった話:PR作成からFirestore連携・インフラ運用まで

高コスパなAIエージェント「Grok Bot」を試してみた

コストと性能のバランス:高額エージェントからGrok Botへの移行

月額約16,000円前後かかる常時稼働型エージェント「dots」は魅力的な選択肢ではあるものの、個人の開発・運用環境で日常的に使い続けるにはややコストの重さがネックでした。そこで、月額約3,000円程度で手軽に導入できる「Grok Bot」を試してみることにしました。

過去にオープンソース系のOpenClawなどを試した際は、精度の粗さやトークンを無駄に消費しているような挙動が気になり、常用には至りませんでした。しかし技術の進歩は著しく、最新のGrok Botは想像以上に実用的で、開発の相棒として十分頼りになるレベルへ到達しています。

実践での活用例:PR作成からFirestoreのデータ要約まで

Grok Botを実際の開発環境に組み込んでみたところ、GitHubでのPull Request(PR)作成や、Google Cloud Firestoreを参照したデータ要約・レポート作成などを柔軟にこなしてくれました。

以下は、実際に検証した主なタスクと成果の記録です。

1. データ収集ツールの不具合解消とTerraformの権限設定

Go言語で開発している情報収集バッチ(Firestoreへ記事を保存する処理)において、外部APIのレートリミットやタイムアウト時に要約が空のままジョブが正常終了してしまう不具合がありました。

Grok Botに問題箇所の特定と修正PRの作成を依頼したところ、迅速に対応が完了し、無事に本番環境へデプロイできました。また、Terraform適用時に発生したGoogle CloudのIAP(Identity-Aware Proxy)関連の権限不足エラーに対しても、必要なIAMロール(roles/iap.admin)の切り分けと付与を的確に案内してくれたため、インフラの更新もスムーズに完了しました。

2. 経済・投資ダッシュボードでの意思決定カード実装

経済・市場分析ダッシュボードのプロジェクトでは、Firestoreに保存された最新のレポート群を要約するだけでなく、具体的なスタンス(強気/中立/弱気/保留)を提示する「意思決定カード(Decision Card)」機能の追加を行いました。

二次情報のみで根拠が薄い場合は自動的に「保留(Hold)」とする安全設計を取り入れ、Firestoreのコレクション設計からAPIエンドポイント、UI実装に至るPRの作成までを一気通貫でサポートしてくれました。

まとめ:個人開発・運用における実用的なパートナー

Grok Botは単なる会話型AIにとどまらず、リポジトリやクラウド環境と連携させることで、日々の開発や調査業務の負担を大幅に減らしてくれます。

高価格帯のエージェントツールに手を伸ばさずとも、月額3,000円前後の手頃な投資でこれだけの自動化と作業効率化が実現できるのであれば、個人開発や小規模な運用において非常にコストパフォーマンスの高い選択肢と言えそうです。

米国債5%時代と巨額赤字の深層:AI資本集中が招く「高金利の恒久化」

米国債5%台の深層:巨額赤字とAIへの猛烈な資本シフト

アメリカは長年にわたり財政赤字と経常赤字という「双子の赤字」を抱え続けてきました。かつては「世界最大の経済規模とドル基軸通貨体制がある限り、破綻など起こり得ない」という楽観論が市場の主流を占めていました。

しかし、近年の米国債市場を観察すると、その前提が揺らぎ始めている兆候が見て取れます。2026年9月下旬には、米10年国債利回りが5.18%、30年債利回りが5.47%に達するなど、長期金利は高止まりを続けています。

同時に財政の悪化速度も顕著です。米議会予算局(CBO)の財政・経済見通し(The Budget and Economic Outlook: 2026 to 2036)によると、2026年度の米連邦財政赤字は1.9兆ドル(GDP比5.8%)に達する見込みです。さらに民間保有の連邦債務残高は2026年の対GDP比101%から2036年には120%へ膨らみ、超長期見通し(The Long-Term Budget Outlook: 2026 to 2056)の試算では2056年に175%へ達すると予測されています。

なぜ世界最強の経済大国がこれほどの金利上昇と財政拡大に直面しているのか。その実態を紐解くと、単なる放漫財政とは異なる力学が浮き彫りになります。

赤字の正体は「成長投資」ではなく「義務的経費と利払い」

財政赤字を評価する際、最も本質的な論点は「資金の使途が将来の生産能力向上につながるか否か」です。工場や道路、送電網、次世代通信網といったインフラへの先行投資であれば、将来の税収増として回収できるため、過度な悲観論は不要です。

しかし、米連邦財政の内実を精査すると、支出増の大半はインフラ投資ではなく義務的経費で占められています。CBOの分析によれば、歳出増加の主要因は社会保障(Social Security)、高齢者医療保険(Medicare)、そして国債の利払いです。2026年の連邦歳出はGDP比23.3%に達し、過去50年平均の21.2%を大幅に超過しています。一方で歳入は対GDP比17.5%にとどまり、過去50年平均の17.3%と大差ありません。

すなわち、税収が歴史的に不足しているのではなく、人口動態の高齢化に伴う社会支出が構造的に膨張していることが財政悪化の本質です。

加えて、近年は国債利払いの急増という新たな負荷が加わりました。連邦政府の純利払い費は2026年時点で約1兆ドル(GDP比3.3%)にのぼり、国防費に匹敵する規模となっています。CBOの予測では2036年に2.1兆ドル(GDP比4.6%)、2056年にはGDP比6.9%まで達し、社会保障や医療費の単独規模すら凌駕する見込みです。借金そのものが新たな債務を生み出す悪循環がすでに始動しています。

経常赤字とドル資金循環:国家破綻が回避されるメカニズム

これほどの財政圧迫に直面しながらも、米国が即座にデフォルトに陥らないのは、債務が自国通貨であるドル建てで調達され、世界中にその引き受け手が存在するためです。

米国の経常赤字はこの国際金融構造と不可分に結びついています。2025年の経常赤字は1.12兆ドル(GDP比3.6%)を記録しました。米国は国内貯蓄を超過した消費・投資を行っており、その不足分を海外からの資本流入で賄っています。

海外投資家から見れば、「対米輸出で稼いだドルを、米国債や米国株などの米資産に再投資する」という国際的資金循環が成立しています。したがって、経常赤字の存在自体が即座にドルの急落や国債暴落を引き起こすわけではありません。

ただし、このシステムが自律的に維持されるためには、「投資家が米国資産の収益性と安全性に魅力を感じ続けていること」が絶対条件となります。

なぜ米国債利回りは5%台へ跳ね上がったのか

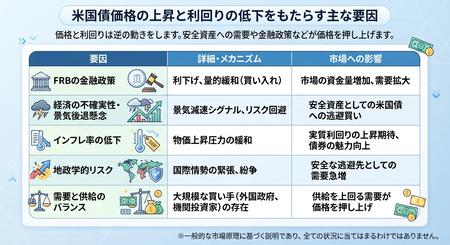
2010年代には、米10年債利回りが1~2%台で推移する低金利期が続きました。世界的な貯蓄過剰、低インフレ、低成長、そして主要中央銀行による量的緩和(QE)が重なり、「余剰資金は潤沢にあるが有望な投資先が乏しい」環境下で、安全資産である米国債が低利回りでも積極的に買われていました。

現在のマクロ環境は一変しています。米政府による国債の大量発行、根強いインフレ懸念、中央銀行のバランスシート縮小が進むなか、民間セクターからかつてない巨大な資金需要が立ち上がりました。その震源地こそが人工知能(AI)です。

つまり、5%を超える高金利の背景には、「米国債の信用失墜」だけでなく、「資本の保有側が魅力的な貸し先・投資先を見出したことで、安全資産側に高い上乗せ利回りを要求している」という好況の側面が強く作用しています。

「電力をお金に変える」AI産業の資本吸引力

現代の生成AI産業をサプライチェーンとして捉えると、「電力 → 先端GPU → 計算資源(Compute) → トークン(Token) → 収益」という巨大な資本・エネルギー変換インフラと定義できます。「電気代+GPU減価償却費+データセンター設備費+資本コスト」を上回る対価で計算能力やサービスを販売できる限り、極めて強固なキャッシュ創出力を持つビジネスモデルが成立します。

その結果、米国の民間設備投資(Business Fixed Investment)には極端な偏向が生じています。米連邦準備制度(Fed)の動向分析でも指摘されている通り、2025年に前年比5.5%増を記録した民間設備投資は、2026年第1四半期に年率11%のペースへ急伸しました。

Fedの試算によれば、データセンターや先端IT機器、ソフトウェアなどAI関連インフラ投資だけで、2026年第1四半期の米実質GDP成長率(年率換算)を約1.36ポイント押し上げたと推計されています。非AI関連の一般オフィスや従来型製造施設への投資が停滞する一方で、AIエコシステム周辺のみが世界中の遊休資本を猛烈な勢いで吸い上げているのが実態です。

創造的破壊の進展:AI関連企業と旧来型企業の二極化

AIインフラが高い投下資本利益率(ROIC)を叩き出す局面において、資本市場ではシビアな比較淘汰が行われます。「利回り5%超の安全な米国債」「期待リターン10%以上のAIデータセンター」「利回り5~7%前後に低迷する旧来型ビジネス」が同一の土俵で比較されるためです。

無リスク金利が5%存在する市場では、リスク資産への投資にはそれ相応のハードルレート(最低要求利回り)が課されます。その結果、巨額の資本・電力・高度人材がAIや先端半導体、エネルギーインフラへと集中していきます。AIを利活用できない旧来型企業では、以下のような連鎖反応が不可避となります。

  • 資本コストの上昇(資金調達の難航)
  • 設備投資余力の縮小
  • 人材獲得や賃金の抑制
  • 競争力の低下と収益減衰

AI企業の隆盛と既存企業の衰退は背反する現象ではなく、ヨーゼフ・シュンペーターが提唱した「創造的破壊(Creative Destruction)」の過程として同時に進行します。

単純な二項対立ではない:企業を分かつ3つの類型

ただし、産業界を単に「AI企業か非AI企業か」という二元論で捉えるのは現実的ではありません。現在の市場は以下の3グループへ分化しています。

  1. AIインフラの直接提供者:GPUメーカー、電力会社、ハイパースケーラー、データセンター事業者など、「電力と計算資源をトークンへ変換する」供給網の基幹を握る企業群。
  2. AI受容による生産性向上企業:従来の業務プロセスにAIを迅速に統合し、人員やコスト効率を劇的に改善して投下資本利益率を引き上げる既存企業。
  3. AIによる代替に晒される停滞企業:コア業務をAIソリューションに侵食されながらも、自社組織の構造改革や生産性向上にAIを結びつけられない企業群。

勝敗の分水嶺は「AI開発企業であるか」ではなく、「AIを活用して投下資本の生産性を高められるか」という点にあります。

AIの成功がもたらす「高金利の恒久化」というパラドックス

この産業構造の地殻変動を国債市場へ還元すると、極めて逆説的な帰結が導かれます。もしAIへの先行投資が過剰投資に終わり失敗すれば、資金需要の減退を通じて金利には低下圧力がかかります。しかし、AIインフラへの投資が十分な超過リターンを生み続ける限り、市場のマネーは民間投資へ優先配分され、米政府は国債消化のために高い金利を提示し続けざるを得なくなります。

すなわち、「AI革命が成功を収めるほど、米国の長期金利は高止まりしやすくなる」という構造的連動です。

民間企業は事業から15%のリターンが得られるのであれば、5%の金利で資金を調達しても十分に採算が合います。一方で、政府が社会保障費や医療費を賄うために5%で発行する国債は、新たな将来キャッシュフローを生み出しません。「民間には高金利でも資金を投じるべき好機が広がる反面、政府部門は既存の莫大な債務を高金利でロールオーバー(借換)し続けなければならない」という非対称なストレスが定着します。

米国財政の真のリスク:急発進の崩壊ではなく漸進的な圧迫

米連邦財政が直面する本質的な脅威は、ある日突然の債務不履行(デフォルト)ではありません。国債増発、利払い費の膨張、赤字再拡大、さらなる国債発行という「静かなクラウディング・アウト」の長期化です。

CBOの感応度分析によれば、金利が長期想定から恒久的にわずか1パーセントポイント上振れるだけで、2056年の公債残高はGDP比175%から222%へと跳ね上がります。債務残高を現行のGDP比101%程度で安定化させるには、2026年から2056年にかけて利払い費を除いた基礎的財政収支(プライマリーバランス)をGDP比で約1.9ポイント改善させる構造改革が求められます。しかし、増税や給付抑制は政治的コストが極めて高く、実行の難易度は極めて高いのが実情です。

今後の世界経済と市場を読み解く指標は、単なる連邦債務の絶対額にとどまりません。AI関連と非AI関連の設備投資格差、実質金利の推移、連邦債務の平均調達金利、そして利払い費のGDP比率を多面的に追跡する必要があります。

AI主導の新たな成長フロンティアと、旧来型経済および財政部門にのしかかる高金利ショックの併存。現在のアメリカで進行している事象は、単なる財政規律の弛緩ではなく、グローバル資本の配分先が根本から塗り替えられる歴史的転換期の一局面に他なりません。

PiとOh My Piを調査した結果、普段使いにOpenCodeを選ぶ理由

Pi / Oh My Piを調べた結果、普段使いはOpenCodeで良さそうだと思った話

最近、Codexから別のcoding agent(AIコーディングエージェント)への移行を検討し始めました。

移行を考えた主な理由は、大きく分けて2点あります。

1つ目は「トークンコスト(Token Cost)」です。 Codexのような高機能なcoding agentは非常に強力ですが、起動時の初期コンテキストやツール定義の読み込みだけで、相応のトークンを消費してしまいます。

一方で、PiやOpenCodeのような比較的軽量なハーネスであれば、より小さな初期コンテキストから無駄なくセッションを開始できます。

2つ目は「モデル選択の自由度」です。 日常の軽微な修正や調査タスクにまで、常にAnthropicやOpenAIのモデルを使う必要はありません。

例えば、以下のようにタスクの難易度に応じてモデルを柔軟に使い分ける運用が理想的です。

  • コード調査・探索:DeepSeekなどの安価で高速なモデル
  • 通常の実装作業:中価格帯のバランス型コーディングモデル
  • 難解なバグ修正・設計:GPTやClaudeのフラグシップモデル
  • コードレビュー:バイアスを避けるための別系統モデル

このようにモデルを適材適所でルーティングできれば、開発効率と費用対効果は劇的に向上します。 その文脈でまず気になったのが「Pi」でした。

Piは思ったより機能が少なくない

最初にPiを見たときは、「軽量な代わりに機能もかなり削ぎ落とされたCLIエージェント」という印象を持っていました。

しかし内部仕様を調べていくと、その認識は少し異なっていました。

Piはオールインワン型のエージェントではありませんが、エージェントを自作・拡張するためのプリミティブ(基本部品)が非常に高いレベルで揃っています。

  • Agent Skills(機能拡張)
  • Extension API
  • Lifecycle events(各種イベントフック)
  • Custom tools(独自ツール定義)
  • Provider切り替え
  • SDK / RPCインターフェース
  • セッション管理

特にAgent Skillsは SKILL.md 形式 を採用しているため、CodexやClaude Codeなど他のツールとプロンプトやスキル資産をシームレスに共有できます。

つまりPiは、「完成された高機能エージェント」というよりも、「コーディングエージェントを自由に構築するためのプログラマブル・ハーネス」と捉えるほうが正確です。

Skills、Subagents、Hooksの役割分担

Piのアーキテクチャを読み解くと、ワークフローを構成する要素は綺麗に3つへ整理できます。

  1. Skills:エージェントに「どう仕事を進めるか」を教える
  2. Subagents:仕事を「誰に担当させるか」を分離する
  3. Extensions / Hooks:タスクを「いつ・どのような条件で実行するか」を制御する

例えば自動レビュー付きの実装フローを組む場合、以下のような構成が考えられます。

Main Agent
   ↓
実装(Implement)
   ↓
Reviewer Subagent
   ↓
問題あり → 修正 → 再レビュー

さらにLintやテスト実行のような決定論的(deterministic)なタスクは、わざわざSubagentに推論させる必要はありません。

ツール実行
   ↓
Hookが検知
   ↓
Formatter / Linter / Test を実行

このようにExtension側へ任せることで、決定論的な処理とLLMの推論を綺麗に分離できます。この基盤設計は思っていた以上に洗練されていました。

Subagentだけでワークフローを組むわけではない

当初は「Piで高度な処理を作るなら、Subagentを何重にも組み合わせる必要があるのか」と考えていました。

しかし、何でもSubagent化するのが正解ではありません。

例えば「コードを書き、テストを回し、コケたら直す」という直線的な試行錯誤であれば、Main Agent自身のループで十分完結します。

一方で、独立したコンテキストを持たせるべきなのは以下のようなケースです。

  • 正確性の検証(Correctness review)
  • パフォーマンス評価(Performance review)
  • アーキテクチャの整合性確認(Architecture review)

作業履歴のノイズを排した客観的な視点が欲しい場面でこそ、コンテキストを分けたSubagentが真価を発揮します。

さらに「レビュー結果が一定基準を満たさなければ再実装へ差し戻す」といった条件分岐ループまで組み込みたいなら、ExtensionやSDKを使ってコード側で制御フローを書くのが確実です。

つまりPiにおいて、Subagentはワークフローエンジンそのものではなく、「ワークフローを組み立てるためのパーツ」に過ぎないという位置付けです。

イベント駆動のHooksとループエンジニアリング

PiにはClaude Codeの「Hooks」と全く同名の機能が標準搭載されているわけではありませんが、Extension Eventsが実質的に同等の役割を果たします。

  • tool_call(ツール呼び出し時)
  • tool_result(ツール実行後)
  • session_start(セッション開始時)
  • agent_end(エージェント終了直前)

これらをフックできるため、例えば「エージェントがタスク完了を宣言しようとした瞬間、自動でテストを実行し、失敗していれば終了を阻止して修正ループへ戻す」といった品質ゲート(Quality Gate)を構築可能です。

実装 → レビュー → テスト → 品質チェック → 修正 ↺

このようなループエンジニアリング(Loop Engineering)を試したい人にとって、Piのイベントシステムは非常に魅力的な土台となります。

ただし、Piには「あえて存在しない」ものも多い

Piの思想は「必要最小限のプリミティブは提供するが、完成済みのリッチなワークフローはユーザーに委ねる」というスタンスです。

そのため、素のPiには以下のような機能が標準では含まれていません。

  • 組み込みのSubagents構成
  • Plan mode(計画と実行の分離)
  • MCP(Model Context Protocol)対応
  • LSP連携 / デバッガ連携
  • グラフィカルなパーミッション確認UI
  • バックグラウンドプロセス管理

Extensionやコミュニティ製パッケージを追加すれば補えますが、「どのプラグインを導入し、どう構成するか」をすべて自分で設計・保守する必要があります。 これはカスタマイズ性の高さであると同時に、実用化までのセットアップコストが高いという裏返しでもあります。

実用上ボトルネックになりやすい「Background Bash」

実際に調査していて気になったのが、バックグラウンドプロセスの扱いでした。

単にシェル上で npm run dev & を実行できれば済む話ではありません。 コーディングエージェントの実務では、次のようなインタラクティブなサイクルが頻繁に発生します。

サーバー起動 → コード修正 → 標準出力を監視 → エラー検知 → 再修正 → ログ確認

これを安定して回すには、以下のようなプロセス管理の仕組みが不可欠です。

  • background_start()
  • background_output()
  • background_list()
  • background_kill()

Pi上でも自作可能ですが、こうした細かな「日常の開発体験の快適さ」を自分で作り込み、メンテナンスし続けるのは骨が折れます。 このあたりから、「エージェント自体の開発・保守に時間を取られすぎるのではないか」という懸念が生まれました。

「Oh My Pi(OMP)」という選択肢

そこで浮上したのが、Piをコーディング用途特化で大幅に強化したディストリビューションである Oh My Pi (OMP) でした。

OMPは、素のPiに欠けていた開発用ツール群を初期状態で贅沢に組み込んでいます。

  • LSP連携およびDAP(Debug Adapter Protocol)デバッガ
  • Subagents機構
  • バックグラウンドプロセスマネージャ
  • MCP統合
  • Worktreeによる作業環境の隔離
  • エージェントハブ

特にLSPとデバッガの統合は強力です。 エージェント自身がブレークポイントを設定し、ステップ実行しながらスタックトレースや変数の値を確認して原因究明を行うことが可能です。C++やGo、Rustなどの静的型付け言語では大きな威力を発揮します。

またSubagentについても、GitのWorktreeを切って完全に隔離された作業ツリー上で並列タスクを実行させられるなど、ランタイムとしての完成度は非常に高いです。

OMPは「Agent OS」に近い

OMPを詳しく見ていくと、単なるPiの便利版を超えて、一種の「Agent OS」のような領域に達していることが分かります。

LSP、DAP、プロセス管理、モデルルーティング、洗練されたTUIなどが統合されており、Extension経由でSubagentの動的生成、停止制御、モデルの切り替え、LLMの内部呼び出しまで深く介入できます。

「自分だけの究極のコーディングエージェントを一から構築したい」というハッカー気質な開発者にとっては、極めて刺激的なプロジェクトです。

ここで湧き上がった疑問:OpenCodeでよくないか?

しかし、OMPの機能群を俯瞰したところで、一つの率直な疑問に突き当たりました。

「これだけの機能を求めるなら、最初からOpenCodeを使えばよいのでは?」

現在急速に支持を集めているOSSエージェント OpenCode には、既に実用上必要な機能が一通り揃っています。

  • SkillsおよびSubagentsのサポート
  • バックグラウンドセッション
  • MCP対応と豊富なプラグイン機構
  • カスタムツールとBefore/Afterフック
  • LSP統合
  • 75以上のプロバイダ対応、OpenRouter連携、ローカルモデル対応

加えて、OpenCodeは非常に大規模なオープンソースコミュニティを形成しており、コントリビューター数やプラグインの更新頻度、ドキュメントの充実度が突出しています。

数年にわたって仕事道具として付き合っていくことを考えると、「コミュニティによってメンテされ続ける安心感」は無視できない要素です。

Pi / OMP と OpenCode の本質的な違い

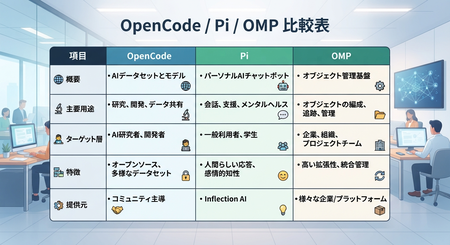
比較を進めた結果、両者の違いは「機能の有無」ではなく「提供しているレイヤー」にあると整理できました。

  • OpenCode:すでに完成されたコーディングエージェントであり、実用的な枠組みの中で柔軟に拡張できる
  • Pi:コーディングエージェントの基盤そのものを自分で設計・プログラミングするためのハーネス
  • Oh My Pi (OMP):Piの自由度を保ちつつ、実用に必要な機能をフルスタックで組み上げたヘビー級環境

OpenCodeであっても、カスタムツールの追加、ツールの前後に挟むフック処理、システムプロンプトやモデルの動的変更などは容易に行えます。 日常の開発で「少し自分好みのワークフローを作りたい」という程度であれば、OpenCodeの拡張性で十分に事足ります。

PiやOMPが真に真価を発揮するのは、以下のようなディープな領域に踏み込む場合だけです。

  • エージェントの終了判定ロジック自体を根本から書き換える
  • Subagent起動時のモデルルーティングを独自ステートマシンで厳密に制御する
  • TUIやランタイムのコア挙動を一から作り直す

自分が求めていた原点に立ち返る

ここで、そもそもなぜ別のツールを探し始めたのかという原点に立ち返ってみました。

  1. 初期コンテキストを小さくしてトークンコストを抑えたい
  2. 安価なモデルを適材適所で使いたい
  3. タスクに応じて柔軟にモデルを切り替えたい
  4. 必要に応じて、手軽にカスタムワークフローを組みたい

目的はあくまで「日々のコーディングを低コストかつ快適にすること」であり、「コーディングエージェントのランタイム自体を研究・開発すること」ではありませんでした。 そう考えると、PiやOMPの最大の強みである極限の自由度は、自分の用途にはややオーバースペックでした。

結論:普段使いにはOpenCodeの「軽量運用」が最もバランスが良い

総合的に判断した結果、現時点の最適解は「普段使いにOpenCodeを採用すること」に落ち着きました。

構成としては以下のようなミニマルなセットアップを想定しています。

  • OpenCode本体
  • OpenRouter経由の柔軟なモデルルーティング
  • 用途に応じた安価なモデルの割り当て
  • 必要最小限のSkillsとプラグインのみを読み込む

OpenCodeもあれこれとツールやMCPを無秩序に読み込めば、当然ながら初期コンテキストは肥大化してしまいます。 だからこそ、「OpenCodeをあえてPiのように最小構成で運用する」という意識が重要になります。

無駄なプラグインを削ぎ落とし、必要な機能だけをオンデマンドで呼び出す構成にすれば、トークンコストを最小限に抑えつつ、OpenCodeのリッチな恩恵を受けられます。

CodexとOpenCodeの使い分け方針

とはいえ、長年信頼してきたCodexを完全に手放すわけではありません。 今後はそれぞれの強みを活かした併用運用を考えています。

  • Codex:難易度の高いアルゴリズム実装、大規模なリファクタリング、絶対に壊したくないクリティカルな開発
  • OpenCode:普段の機能実装、コードベースの調査、定型的なバッチ処理、安価なモデルによる試行錯誤

まずは「Codex 80% / OpenCode 20%」くらいの比率からスタートし、OpenCodeの安定性を確かめながら徐々に比率をシフトしていく予定です。

おわりに:エージェントの解像度が上がった収穫

今回PiやOh My Piを深く調べたことは、ツール選定以上の大きな収穫がありました。

これまでブラックボックスに見えがちだったcoding agentが、どのような部品から成り立っているのかを明確に言語化できたからです。

  • Skill = どう仕事を進めるか
  • Subagent = 誰に仕事を任せるか
  • Hook = いつ割り込んで何を強制するか
  • Harness = それらをどう束ねてループを回すか

このメンタルモデルが手に入ったことで、今後CodexやOpenCodeを使う際にも、より解像度の高いプロンプト設計やワークフロー構築ができると感じています。

まずはCodexをメインの守り神として維持しつつ、OpenCodeの薄い構成をじっくり試していこうと思います。

『魔法少女ノ魔女裁判』クリア感想:遊びやすさが光る良作推理ゲーム

『魔法少女ノ魔女裁判』クリア感想:遊びやすさが光る良作推理アドベンチャー

『魔法少女ノ魔女裁判』をクリアしました。クリアまでのプレイ時間は、およそ13時間です。

推理ゲームとしての遊びやすさ

推理ゲームとしては、かなり楽しめる良作でした。序盤は展開がわからなくても、ゲームを進めていくうちに少しずつ情報が整理され、自然とストーリーの全体像が見えてくる構成になっています。

最初からトリックが簡単に見抜けるわけではありません。一方で、難しすぎて何をすればいいのかわからなくなり、進行が止まってしまうこともありませんでした。この「考えればわかりそうで、わからなくても先へ進める」バランスは、とても良かったと思います。

難しい場面で選択肢を間違えても、直前からやり直せる点も親切でした。試行錯誤を前提に遊べるため、失敗するたびに大きく戻されるストレスがありません。推理ゲームに慣れていない人でも、比較的遊びやすい作品だと思います。

ストーリーの意外性にはやや物足りなさも

一方で、『ダンガンロンパ』や『逆転裁判』といった過去の名作と比べると、ストーリーの意外性はやや控えめに感じました。

アドベンチャーゲームの名作には、プレイヤーの想像を大きく超えるような展開や、あとから振り返って納得できる強烈などんでん返しが求められることがあります。その点では、本作には少し物足りなさがありました。

第1章のラストには印象的などんでん返しがあります。しかし、それ以降は物語全体として大きく予想を裏切るというより、比較的無難な流れで進んでいく印象です。もちろん、これは過去の名作と比較した場合の話であり、本作単体の完成度を否定するものではありません。

それでも完成度の高い作品

とはいえ、最終的に伝えたいのは「よくできた作品だった」ということです。

ストーリーを理解しやすくする構成、適度な推理の難度、失敗してもやり直しやすいシステムなど、プレイヤーが最後まで遊びやすいように丁寧に作られていました。驚きの強さでは少し物足りなさがあるものの、推理アドベンチャーとしての手触りは良く、13時間ほどで満足感を得られる作品です。

過去の名作級の衝撃を期待すると肩透かしに感じるかもしれませんが、遊びやすくまとまった推理ゲームを探している人にはおすすめできます。

推論チップとFrozen v2から考えるAIシステムの評価

Frozen v2とは何か?Gemini専用AIチップ構想を読み解く

結論:固定構成の評価手法ではなく、Gemini向けAIチップのコードネーム

Frozen v2とは、Googleが生成AIモデル「Gemini」の推論に特化して開発していると報じられた、サーバー向けAIチップの内部コードネームです。

下書きでは、Frozen v2を「モデルや実行環境を固定したうえで、性能・品質・安定性を検証する評価プロセス」として説明していました。この考え方自体はAIシステムの評価方法として有用ですが、現在報道されているFrozen v2とは別の概念です。

2026年7月21日時点で、GoogleによるFrozen v2の正式発表、製品仕様、実測ベンチマークは確認できません。報道では、Geminiの処理特性をハードウェア設計に組み込み、Googleの最新TPUと比べてトークンあたりの電力効率を6〜10倍高める可能性や、2028年頃の導入が言及されています。ただし、これらは未発表の計画に関する報道であり、Googleが公開した性能値ではありません。The Informationの報道

したがって、現時点でFrozen v2について断定できるのは、報道された開発計画と、そこから合理的に推測できる技術的な意義までです。

Frozen v2と固定構成評価は別の概念

本稿では、用語を次のように整理します。

用語 本稿での意味
Frozen v2 GoogleがGemini向けに開発していると報じられた専用AIチップ
Frozen v2評価 Frozen v2のような固定用途チップを評価するための方法論
固定構成評価 モデル、チップ、ランタイム、入力条件などを固定して継続的に測定する評価プロセス

この区別をしないまま記事を構成すると、「Frozen v2という製品の説明」と「AIシステムの評価方法」が混在し、論点がぼやけてしまいます。

固定構成評価は、Frozen v2を検証する際に活用できる方法論です。しかし、それ自体がFrozen v2を意味するわけではありません。

報道されているFrozen v2の位置づけ

報道ベースでは、Frozen v2は次のような構想として説明できます。

Google Geminiの推論に特化したサーバー向けAIチップであり、Geminiのニューラルネットワーク構造やデータ処理方式の一部をハードウェアに組み込み、汎用的なAIアクセラレータよりもデータ移動や制御処理のオーバーヘッドを削減することを目指すものです。

現時点で報道されている主な特徴は、Geminiの推論処理への特化、トークン生成あたりの電力効率の大幅な改善、そして早ければ2028年頃の導入計画です。ただし、チップの回路構成、搭載メモリ、演算精度、チップレット構成、ネットワーク仕様などは公開されていません。

Googleはこれまでも、AIモデルの学習や推論に利用する独自プロセッサとしてTPUを継続的に改良してきました。TPUの製品情報や利用方法は、Google CloudのTPU公式ドキュメントで確認できます。

Frozen v2が既存のTPUの延長線上にあるのか、それともGemini専用のASICとして別系統に位置づけられるのかは、現在のところ明らかになっていません。ただし、報道どおりGeminiへの特化度が高いのであれば、汎用的なTPUよりもモデルとチップの協調設計を重視した構想だと考えられます。

「Geminiをチップに焼き込む」とは何か

「Geminiのアーキテクチャをシリコンに焼き込む」という表現は刺激的ですが、モデルの全パラメータをそのままチップへ固定配線するという意味だとは限りません。

現実には、次のような処理を専用化する構想だと考えるのが自然です。

  • 頻繁に使われる演算パターンの固定回路化
  • 特定のテンソル形状やデータ型への最適化
  • 量子化された重みやKVキャッシュの処理方式の専用化
  • Transformerの一部処理のアクセラレータ化
  • Geminiの実行パターンに合わせたメモリ配置とデータ移動
  • 推論時のスケジューリングやチップ間通信の最適化

つまりFrozen v2は、「Geminiそのものを一枚のチップへ格納する」というより、Geminiが頻繁に行う処理を、汎用的な命令実行よりも短い経路で処理するチップと解釈するのが妥当です。

これは報道内容をもとにした技術的な推測です。Frozen v2の具体的な回路やソフトウェア構成が公開されるまでは、確定的な仕様として扱うべきではありません。

なぜGoogleはGemini専用チップを必要とするのか

AI推論のボトルネックは演算性能だけではない

AIチップを評価するとき、TOPSやTFLOPSは分かりやすい指標です。しかし、大規模言語モデルの推論では、演算器のピーク性能だけでなく、システム全体のデータ処理が性能を大きく左右します。

主なボトルネックには、モデルの重みをメモリから読み出す時間、KVキャッシュへのアクセス、チップ内外のデータ移動、チップ間通信、ホストCPUとの転送、カーネル起動やスケジューリングのオーバーヘッドなどがあります。

また、動的に変化する入力長・出力長に対応しながら、バッチ処理とリアルタイム応答を両立させる必要もあります。

NVIDIAのTensorRT公式ドキュメントでも、推論性能をGPUの演算時間だけでなく、ホスト側処理、データ転送、エンキュー時間、メモリ使用量、アプリケーション全体の処理時間に分けて評価しています。

特にLLMの生成処理では、入力を一括処理するPrefillと、トークンを一つずつ生成するDecodeで、必要な計算資源やメモリアクセスの性質が異なります。

Prefillでは大量の入力トークンを並列処理するため、演算性能が効きやすくなります。一方、Decodeでは1トークンずつ生成するため、メモリ帯域やKVキャッシュへのアクセスが重要になります。

Frozen v2がGemini向けに最適化されるのであれば、特にDecode段階のデータ移動とメモリアクセスを削減する設計が重要になる可能性があります。これは単に「演算速度が速いチップ」を作るという話ではありません。

電力効率がサービスの経済性を左右する

生成AIのコストは、チップの購入費だけでは決まりません。電力、冷却、データセンターの電源容量、ネットワーク、メモリ、チップ間通信、保守、モデル更新、ソフトウェア最適化、障害対応まで含めて考える必要があります。

そのため、仮にFrozen v2が報道どおり6〜10倍の電力効率を実現したとしても、重要なのはチップ単体の性能ではなく、サービス全体でどれだけ有効な出力を生み出せるかです。

実用価値は、次のように考えられます。

実用価値 = 有効な生成トークン数
         ÷(電力+冷却費+運用費+失敗・再試行コスト)

ここでいう「有効な生成トークン」とは、単に出力されたトークン数ではありません。エラー、タイムアウト、再生成、品質基準未達の出力を除き、実際にサービス価値へ変換された出力を指します。

MLCommonsのMLPerf Inference Datacenterでも、アクセラレータ単体ではなく、システム全体の性能や電力、エネルギー効率を評価する考え方が採用されています。

Frozen v2が示すモデルとチップの協調設計

汎用チップから専用チップへ

GPUや汎用TPUの強みは、さまざまなモデルやフレームワークに対応できることです。新しいモデルが登場しても、コンパイラやカーネルを更新すれば、同じハードウェアを使い続けられます。

一方、Frozen v2のような専用チップは、特定のモデルに対して高い性能と効率を実現できる可能性があります。

観点 汎用GPU・汎用AIアクセラレータ Frozen v2のような専用チップ
対応モデル 幅広い Gemini中心に限定される可能性
初期性能 高いが汎用的 特定処理で非常に高い可能性
モデル変更への対応 比較的容易 回路との不整合が問題になりやすい
ソフトウェア資産 豊富 専用コンパイラやランタイムが必要
電力効率 高い 条件が合えばさらに高い可能性
ベンダーロックイン ある より強くなる可能性
投資回収 複数用途で分散可能 Geminiの利用量に大きく依存

この構図は、単純な「GPU対ASIC」の比較ではありません。Frozen v2は、GoogleがGeminiを自社サービスの中心に据え、モデル、クラウド、データセンター、チップを一体運用するからこそ成立する戦略です。

専用化は性能を高める一方で、未来を固定する

専用チップの利点は、不要な汎用性を削れることです。特定の行列演算、テンソル形状、低精度フォーマット、KVキャッシュの読み書き、Attentionの一部、Mixture-of-Expertsの制御、チップ間通信などを専用化できる可能性があります。

しかし、専用化には代償もあります。

Geminiの設計が大きく変わった場合、Frozen v2の最適化が逆に足かせになる可能性があります。新しいAttention方式、異なるMoE構造、新しい推論アルゴリズム、別のマルチモーダル処理方式へ移行すれば、チップ上の固定機能が十分に活用されないかもしれません。

Frozen v2の本質的なリスクは、性能不足ではなく、将来のモデル進化に対する硬直性です。

報道された「6〜10倍」をどう読むべきか

Frozen v2について報道された「6〜10倍」という数字は、現時点では慎重に扱う必要があります。少なくとも、次の条件が分からなければ比較できません。

比較対象がどの世代のTPUなのか、Geminiのどのモデルを使ったのか、入力トークン長と出力トークン長はいくつなのか、PrefillとDecodeのどちらを測ったのか、バッチサイズや同時実行数はいくつなのかといった条件です。

さらに、量子化の有無、生成品質の維持、チップ単体かサーバー全体か、冷却やネットワークを含むのか、どの程度の稼働率で測ったのかも明記されなければなりません。

「トークンあたりの電力」が6倍良くても、品質低下によって再生成が増えれば、実効的な効率は下がります。低負荷時には高速でも、高い同時実行数でp99レイテンシが急激に悪化するなら、対話サービスには使いにくい可能性があります。

したがって、Frozen v2は単一の効率倍率ではなく、次のような曲線で評価する必要があります。

  • 同時実行数とTTFT
  • 同時実行数とTPOT
  • 負荷率とp95・p99レイテンシ
  • モデル品質と量子化率
  • tokens/secとtokens/watt
  • 稼働時間とメモリ使用量
  • エラー率と再試行率

LLMでは平均値より末尾遅延が重要

チャットサービスでは、平均レイテンシだけではユーザー体験を評価できません。

平均応答時間が短くても、一部のユーザーが数秒以上待たされるなら、実際のサービス品質は悪い可能性があります。特にストリーミング応答では、以下の指標を分けて確認する必要があります。

  • TTFT:最初のトークンが返るまでの時間
  • TPOT:トークンごとの生成時間
  • E2E latency:応答全体が完了するまでの時間
  • p50・p95・p99:遅延分布
  • キュー待ち時間
  • タイムアウト率
  • キャンセル率
  • 再試行率

MLCommonsのMLPerf Endpointsも、生成AIサービスの評価では、モデルやチップ単体ではなく、エンドポイントとしてのTTFT、TPOT、tokens/sec、同時実行数などを確認する必要があることを示しています。

Frozen v2を評価するために固定すべき条件

下書きにあった「固定構成を一定期間測定する」という発想は、Frozen v2の評価方法として再利用できます。ただし、Frozen v2という製品名の定義ではなく、専用AIチップを検証するための評価プロトコルとして位置づけるべきです。

ハードウェア条件

チップの型番・ステッピング、チップ数、HBM容量と帯域、ノード構成、チップ間接続、ホストCPU、ネットワーク構成、電力上限、冷却条件、ファームウェア、サーバー温度などを固定・記録します。

モデルとソフトウェア条件

Geminiのモデル世代、チェックポイント識別子、量子化方式、精度形式、コンパイラ、ランタイム、ドライバー、カーネル実装、推論サーバー、トークナイザー、プロンプトテンプレート、サンプリング設定、乱数シード、フォールバック処理を記録します。

特に専用チップでは、未対応演算子がCPUや別のアクセラレータへフォールバックしていないかを確認する必要があります。チップ単体のベンチマークでは高速に見えても、一部の処理が別デバイスへ移動していれば、サービス全体の性能は大きく変わります。

ワークロード条件

LLMの評価では、入力長と出力長を平均値だけで示してはいけません。短文チャット、長文要約、コード生成、エージェント処理、大規模バッチ、マルチモーダル処理など、実際の用途に近いシナリオへ分ける必要があります。

シナリオ 入力 出力 主な評価対象
短文チャット 短い 短い TTFT、操作感
長文要約 長い 中程度 Prefill、メモリ帯域
コード生成 中程度 長い TPOT、総時間
エージェント処理 可変 可変 ツール呼び出し、再試行
大規模バッチ 長い 長い スループット、電力
マルチモーダル 画像・音声を含む 可変 前処理、異種データ処理

MLPerf Inferenceの公式提出ガイドでも、Server、Offline、Interactiveなどのシナリオを分け、用途に応じて異なる測定要件を定めています。

量子化と専用化のトレードオフ

Frozen v2が高い電力効率を実現するには、量子化や専用データパスが重要になる可能性があります。

FP16やBF16からFP8、INT8、さらに低ビット形式へ移行すれば、メモリ使用量とデータ移動量を削減できます。しかし、量子化によって数値誤差、長文推論の品質劣化、コード生成の正確性低下、多言語性能の偏り、ツール呼び出しの失敗、安全性判定の不安定化などが生じる場合もあります。

そのため、量子化後の性能は、単に「何倍高速か」だけでは評価できません。

量子化の実用価値 =(処理量の増加+コスト削減)
                  ÷(品質低下+失敗率増加+保守負担)

Frozen v2のようにハードウェアとモデルを強く結びつける設計では、量子化方式そのものがチップ設計に組み込まれる可能性があります。その場合、後から別の量子化方式へ変更する自由度が低くなり、モデル更新とチップ更新のタイミングを一致させる必要があります。

Frozen v2が抱える主な懸念

モデルの進化速度と半導体開発速度の不一致

AIモデルは数か月単位で更新されます。一方、専用チップの設計、検証、製造、量産には長い時間がかかります。

Frozen v2が2028年頃の導入を目指すとすれば、設計時点のGeminiと、実際の導入時点のGeminiの構造が異なる可能性があります。専用化の度合いが強いほど、この時間差は大きなリスクになります。

ハードウェアへの依存が強くなる

GeminiがFrozen v2に最適化されると、GoogleのAIサービスは独自チップ、コンパイラ、ランタイム、データセンター構成に依存することになります。

Googleにとっては競争力になりますが、利用者側には、他社クラウドとの互換性低下、ベンチマークの比較困難、移行コストの増大、ベンダーロックイン、障害発生時の代替手段不足といった問題が生じる可能性があります。

チップの性能がサービス全体に直結しない可能性

チップが高速でも、APIゲートウェイ、認証、トークナイズ、モデルルーティング、キュー、ネットワーク、データベース、外部ツール呼び出し、出力フィルタリング、ログや監視がボトルネックになる場合があります。

そのため、Frozen v2の評価では、チップ内部のレイテンシとユーザーが観測するエンドツーエンドレイテンシを分けて報告しつつ、最終的には両方を確認する必要があります。

効率化が利用拡大によって相殺される可能性

推論コストが下がると利用量が増え、データセンター全体の電力消費が減らない可能性もあります。

Frozen v2が1トークンあたりの電力を削減しても、Geminiが検索、広告、オフィス、開発支援、エージェント、動画、ロボティクスなどへ広く組み込まれれば、総推論量が増加する可能性があります。

したがって、評価対象は「1トークンあたりの効率」だけでは不十分です。tokens/wattやtokens/dollarといった原単位の効率に加え、データセンター全体の電力、冷却、水使用量、設備投資といった総量の影響も確認する必要があります。

評価で見るべき指標

Frozen v2の評価では、性能だけでなく、品質、効率、信頼性を分けて測定する必要があります。

性能では、TTFT、TPOT、エンドツーエンドレイテンシ、p50・p95・p99・p99.9、tokens/sec、queries/sec、同時実行数、キュー待ち時間、タイムアウト率などを確認します。

品質では、正解率、コード実行成功率、ツール呼び出し成功率、長文タスクの完遂率、マルチモーダル処理精度、量子化前後の品質差、重大エラー率、安全性評価の失敗率などが重要です。

効率では、tokens/watt、tokens/dollar、1リクエストあたりの消費電力量、サーバー全体の平均電力、ピーク電力、冷却を含む電力、低負荷時と高負荷時の効率を測定します。

信頼性では、長時間稼働時の性能劣化、メモリリーク、リクエスト失敗率、ノード障害からの復旧時間、リトライ連鎖の有無、ロールバック時間、モデル更新時の互換性、異常入力に対する挙動を確認します。

NISTのAI Risk Management FrameworkとGenerative AI Profileも、AIシステムを開発時のベンチマークだけでなく、設計、導入、運用、監視、評価を含むライフサイクル全体で管理する考え方を示しています。

評価結果を単一スコアにまとめない

Frozen v2を評価する際、最も避けるべきなのは「総合スコア1位」という結論です。

例えば、システムAは非常に高速で電力効率も高いものの、p99レイテンシと障害復旧に弱いかもしれません。一方、システムBは速度や効率では劣っていても、品質と安定性に優れている可能性があります。

リアルタイムチャットではAが有利でも、金融、医療、企業業務では、p99の安定性や障害復旧を重視してBを選ぶ方が合理的な場合があります。

したがって、採用基準は単一スコアではなく、制約条件付き評価にするべきです。品質が基準値以上であること、p99レイテンシがSLO以内であること、重大エラー率が上限以下であること、tokens/wattが既存システムを上回ること、長時間運用で性能劣化がないこと、モデル更新後も一定の互換性を維持すること、障害発生時に規定時間内で復旧できることなどを個別に確認します。

この方式なら、電力効率だけが高く、品質や安定性に問題のあるチップを、総合点の高さだけで採用するリスクを減らせます。

Frozen v2の本当の意味

Frozen v2の重要性は、単にGoogleが新しいAIチップを作っていることではありません。

より本質的には、GoogleがGeminiのモデル設計、推論ランタイム、専用コンパイラ、AIチップ、メモリ階層、チップ間ネットワーク、データセンター、サービスの負荷分布を一体化しようとしている点にあります。

これまでAIシステムでは、モデル、チップ、クラウド、アプリケーションは比較的別々に評価されてきました。Frozen v2は、その境界を曖昧にする構想です。

そのため、評価の単位も「このチップは何TOPSか」から、次の問いへ移る必要があります。

Geminiを、現実の入力、現実の負荷、現実の電力制約、現実の障害条件のもとで、どれだけ安定して、安く、安全に提供できるのか。

現時点でFrozen v2の仕様や性能を断定することはできません。しかし、もし報道どおりGeminiに深く特化したチップが実現すれば、AIアクセラレータの競争は、汎用的な演算性能の競争から、特定のモデルをどれだけ効率よくサービス化できるかという垂直統合の競争へ進む可能性があります。

重要なのは、「6倍速いのか」「10倍効率的なのか」という数字そのものではありません。その数字が、どのモデルで、どの入力条件で、どの負荷に対して、どの品質を維持し、どの範囲の電力とコストを含め、どれほど長く再現できるのかを明らかにすることです。

Frozen v2は、現時点では確定した製品ではなく、GoogleがGeminiをハードウェアのレベルから最適化しようとしていることを示す、重要だが未検証の開発計画です。